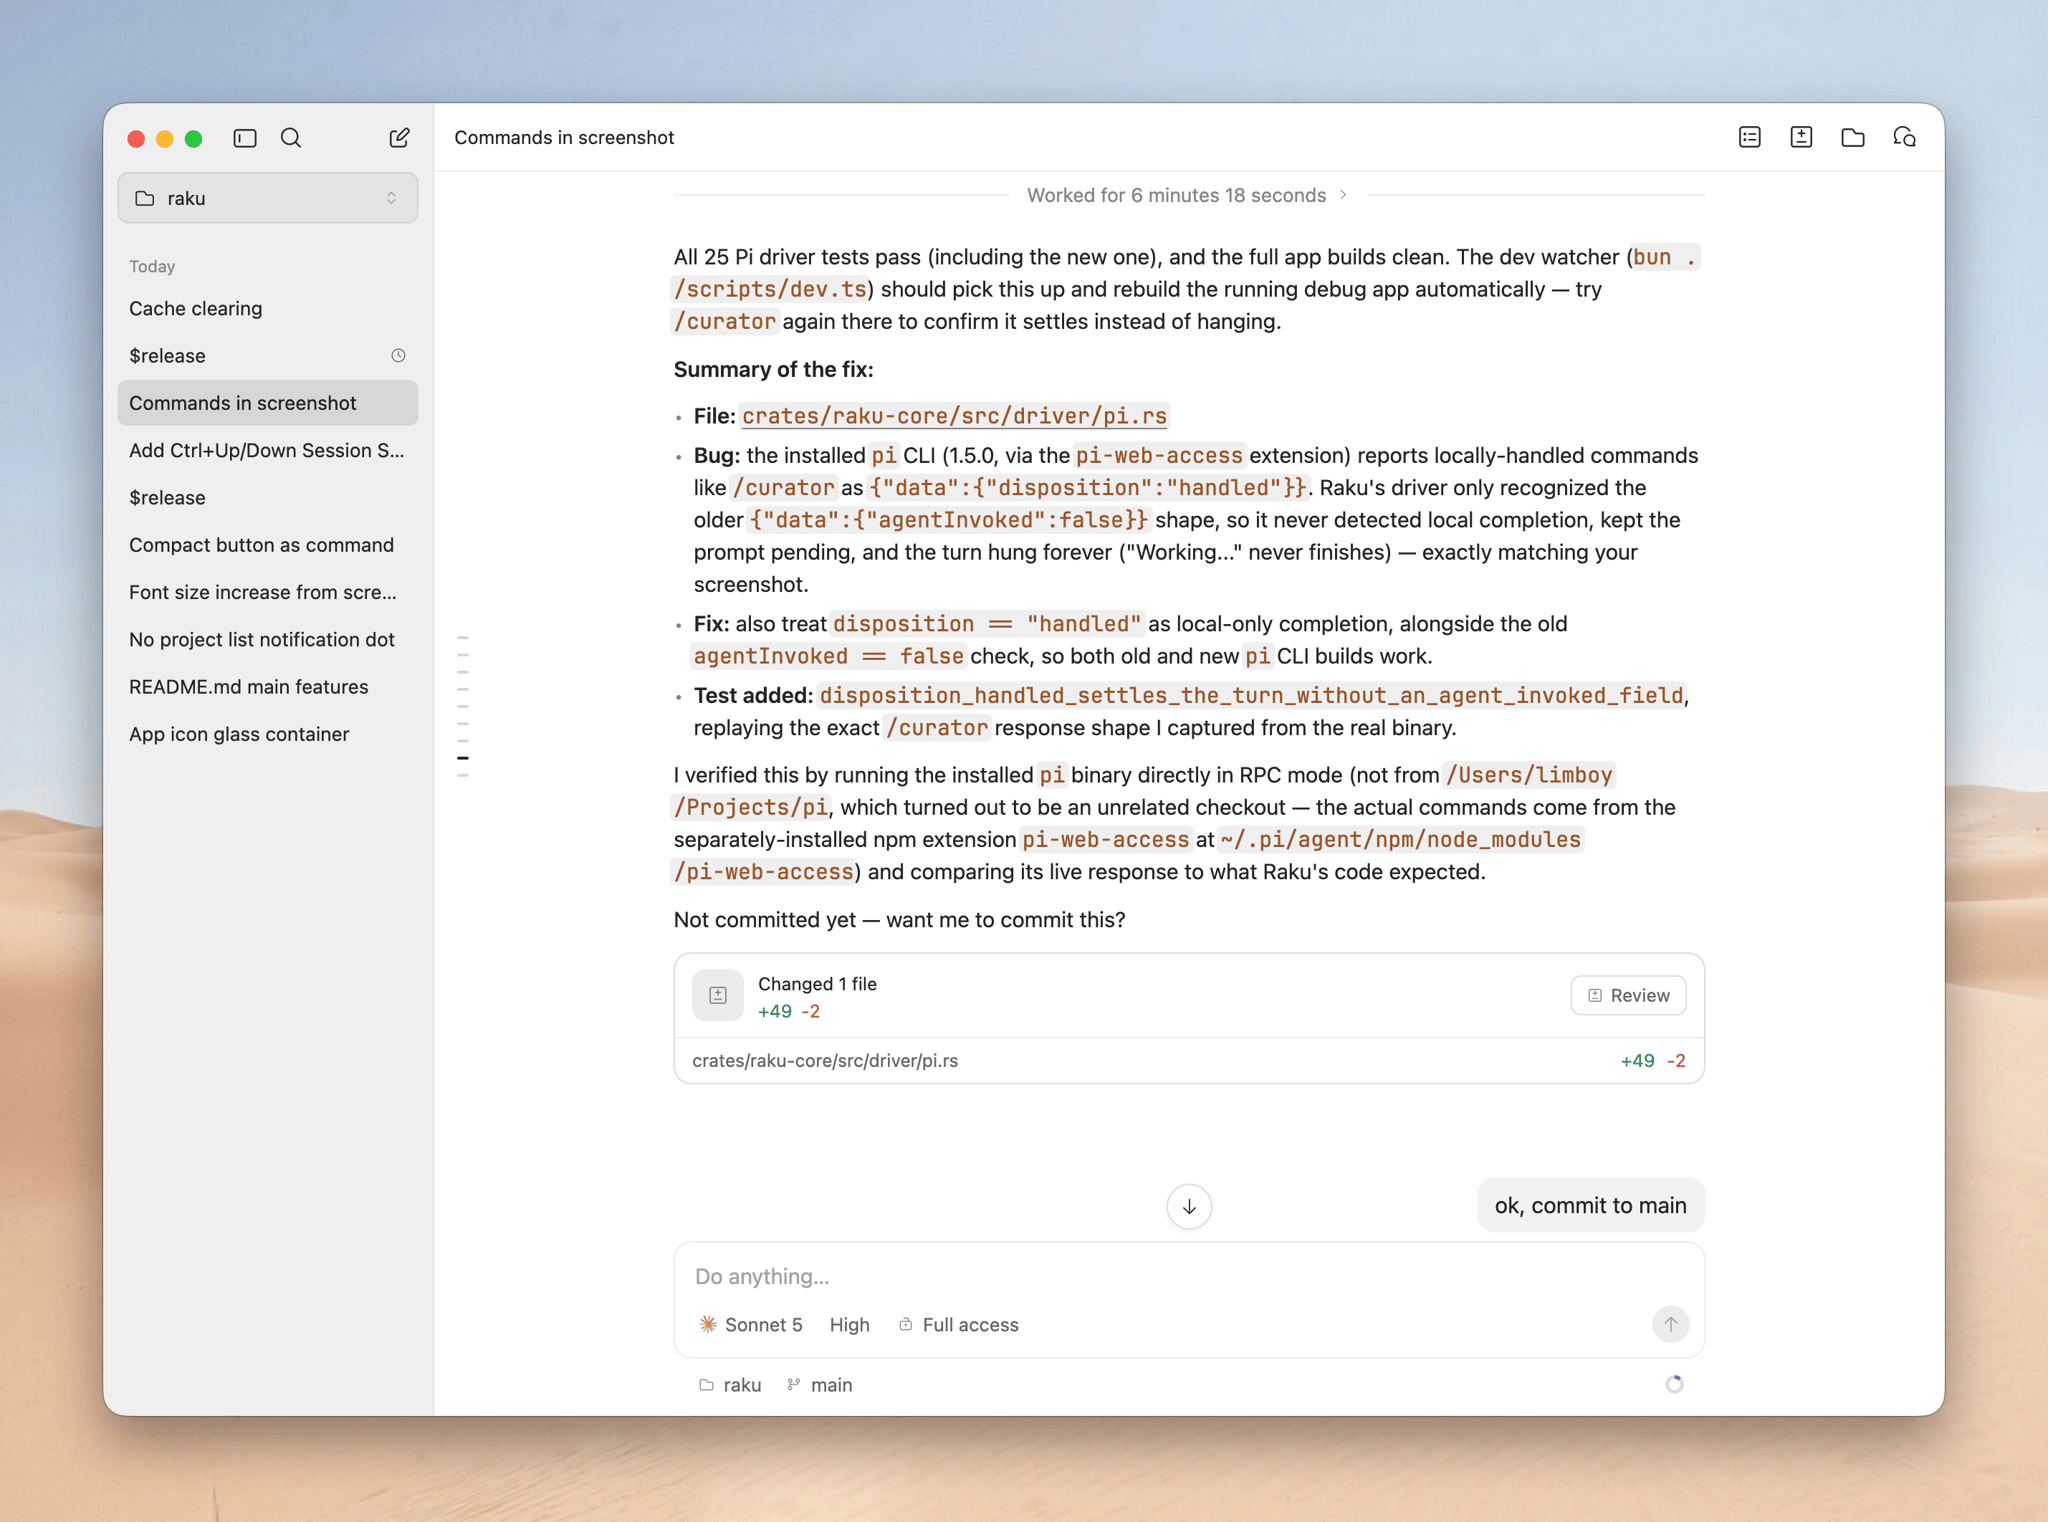
经过一个多礼拜的打磨,我的小浣熊终于在视觉、交互和功能都达到了比较满意的状态。
它是一个桌面端的 Agent Wrapper,目前支持 Codex、Claude Code 和 Pi。至于为什么不用官方的桌面 App,一个是太重了,塞了各种我不太需要的功能,资源占用也较多,也不方便定制功能,使用上有时也不是太顺手,加上我同时订阅了 Claude Code、Codex 以及 OpenCode Go,需要方便切换,也需要一些超轻量的 Agent(比如 Pi) 来处理简易的场景,比如整理一篇文章或解析一段日语。因此一个 Universal Agent Wrapper 就极具必要性了。
GitHub - limboy/raku: ⚡ A native app for your coding agents.
⚡ A native app for your coding agents. Contribute to limboy/raku development by creating an account on GitHub.
 GitHub
感受到了 Bot 的 power,让它盯一下某个需要预约的票(已经约满,只能等别人退票),我提供必要的信息(姓名,邮件等),一天后就帮我蹲到了。网站会发验证码到邮箱,ta 还会提醒我赶紧把验证码发过去,不然怕被别人给抢了😂
如果我们把做出一件作品的能力拆分为能力和品味,高强度地使用 Agent 会不可避免地导致能力的下降,但品味不会,甚至还可能提升。如果不能使用 Tier 0 Agent,就会出现品味和能力的落差(因为 Agent 带来的能力提升有限),也就难做出让自己满意的作品。这其实就是棘轮效应:一旦用过好的,就很难再适应那些差强人意的。
Google’s models will never surpass Anthropic’s — they just don’t have taste.
- 3 个月前在 @owen 那里看到了一个熟客可以自定义咖啡杯的文章,感觉很酷,就把这个 idea forward 给了茑屋咖啡的管理者,and accepted。
- 3 个月后,这个 idea 落地了,我也有了自己的专用杯(画也是自己画的)。
喜欢这种奇妙的连接。
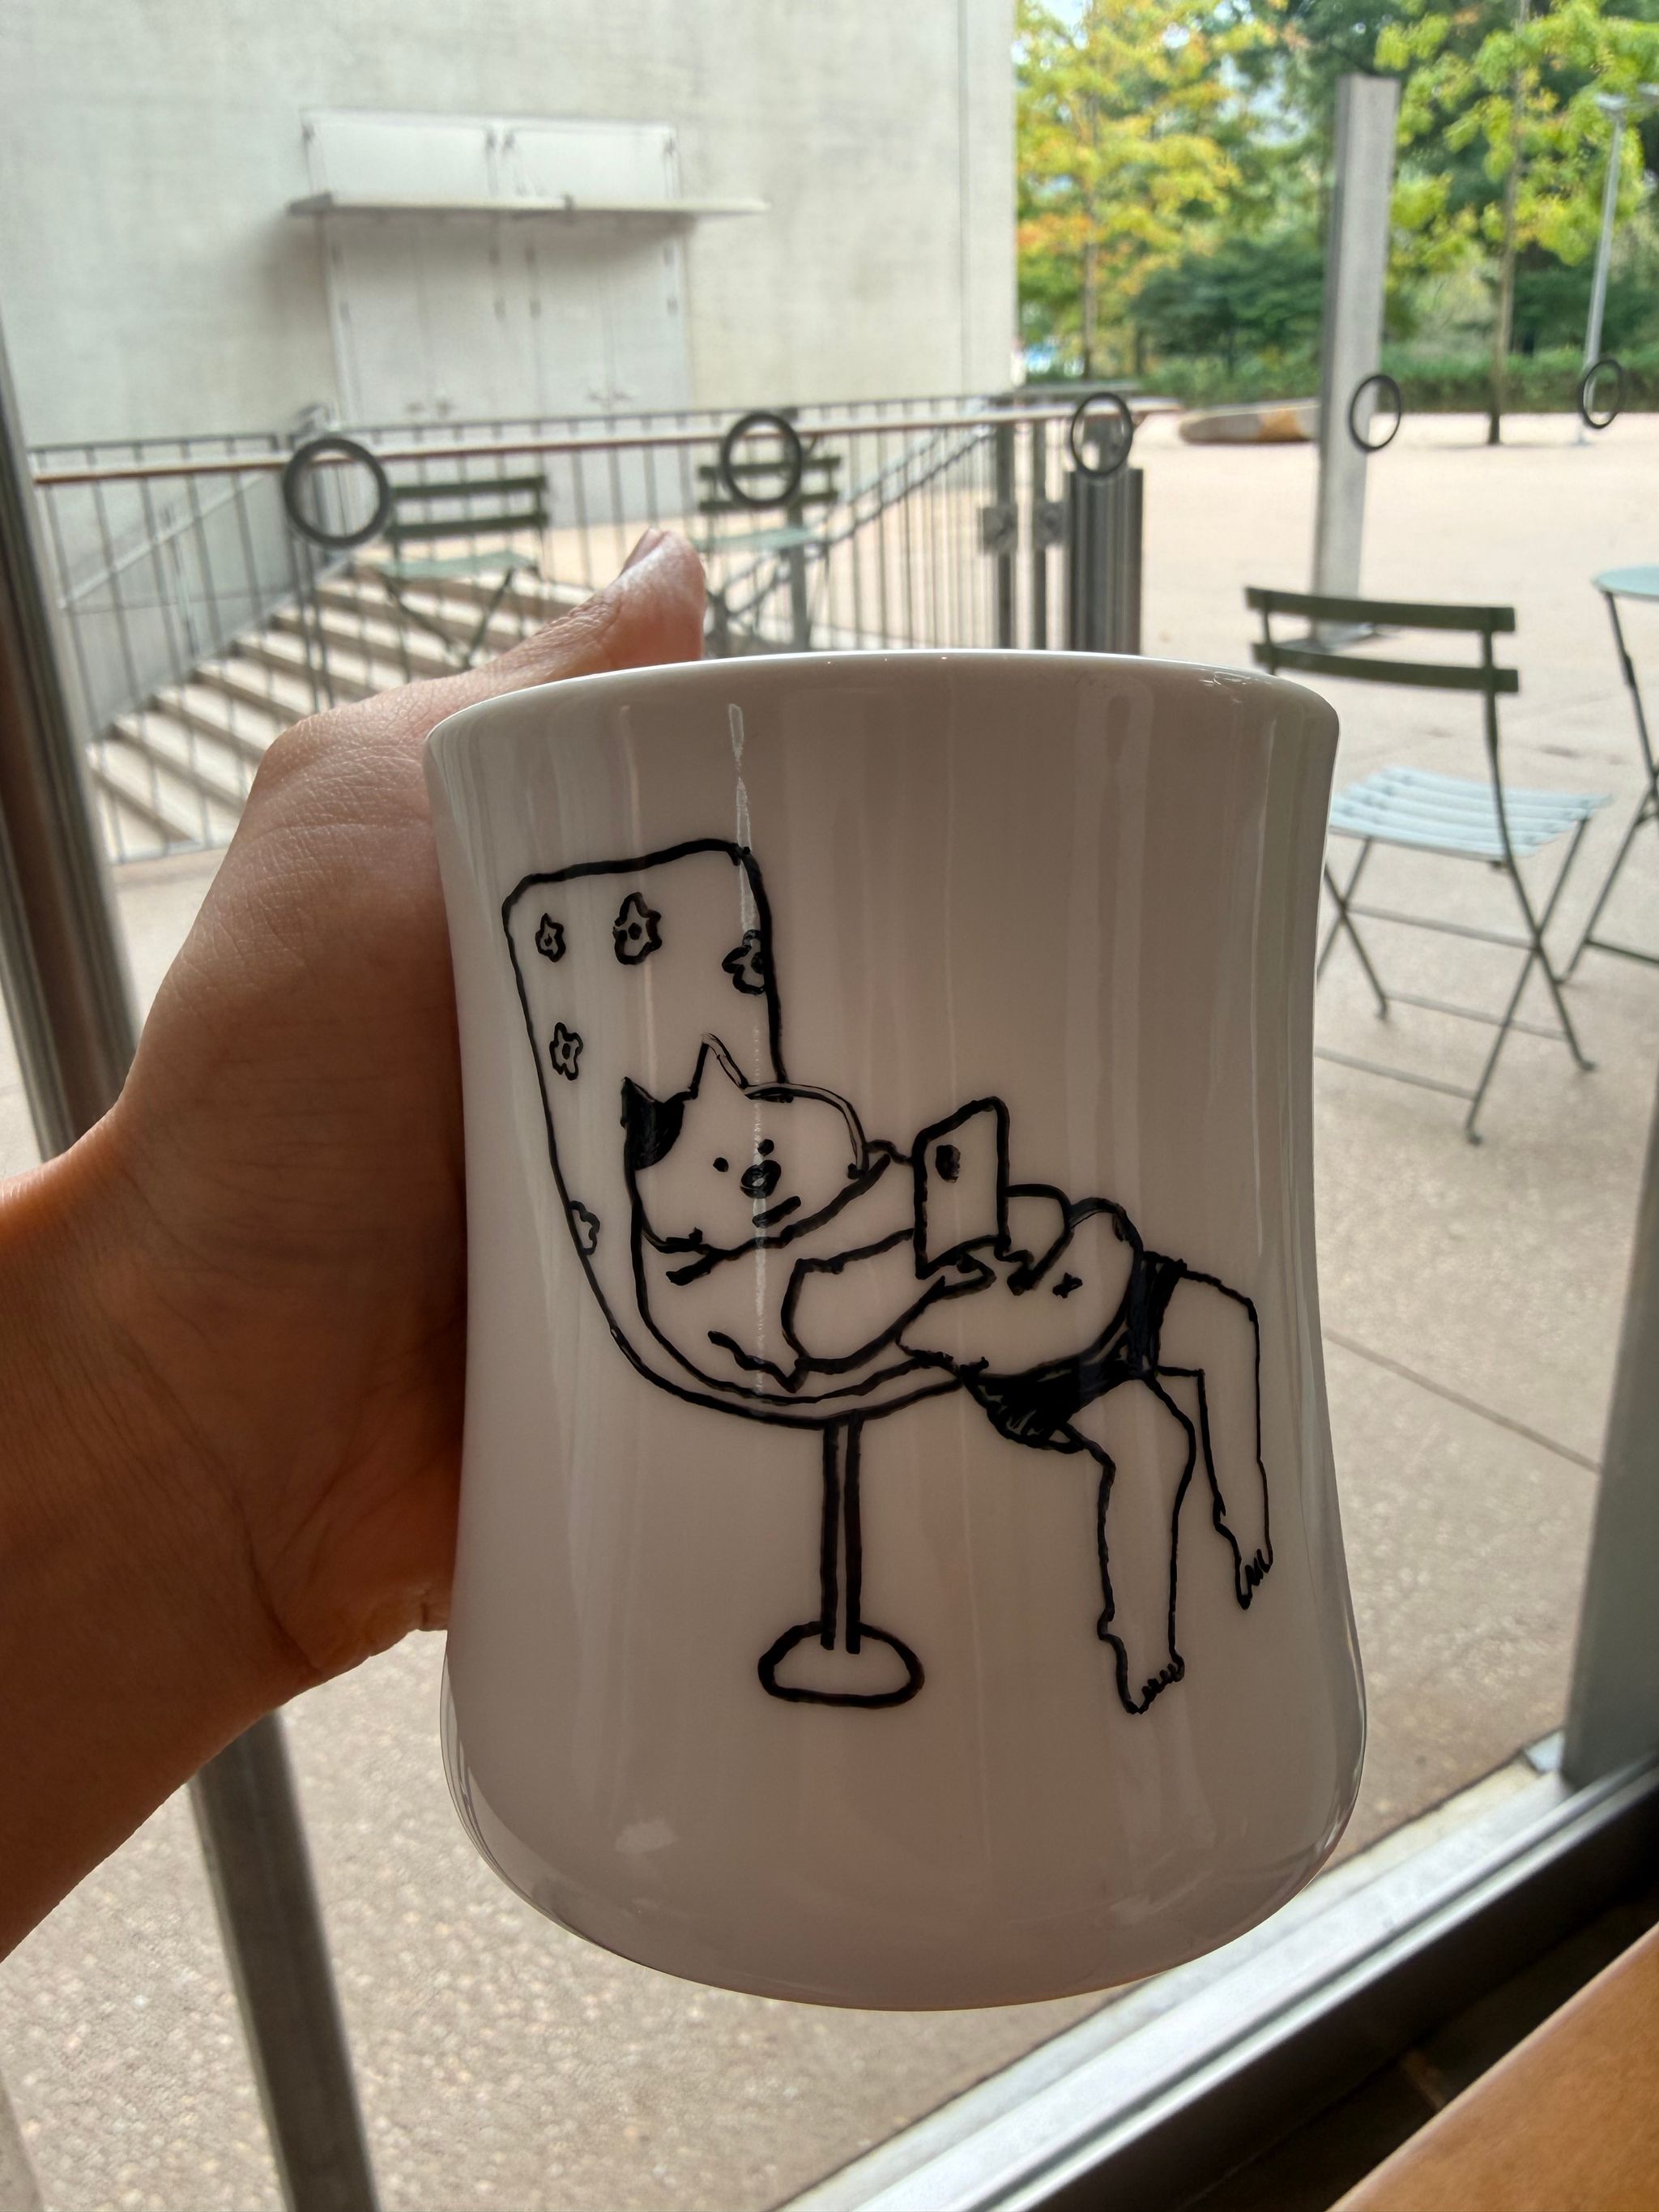
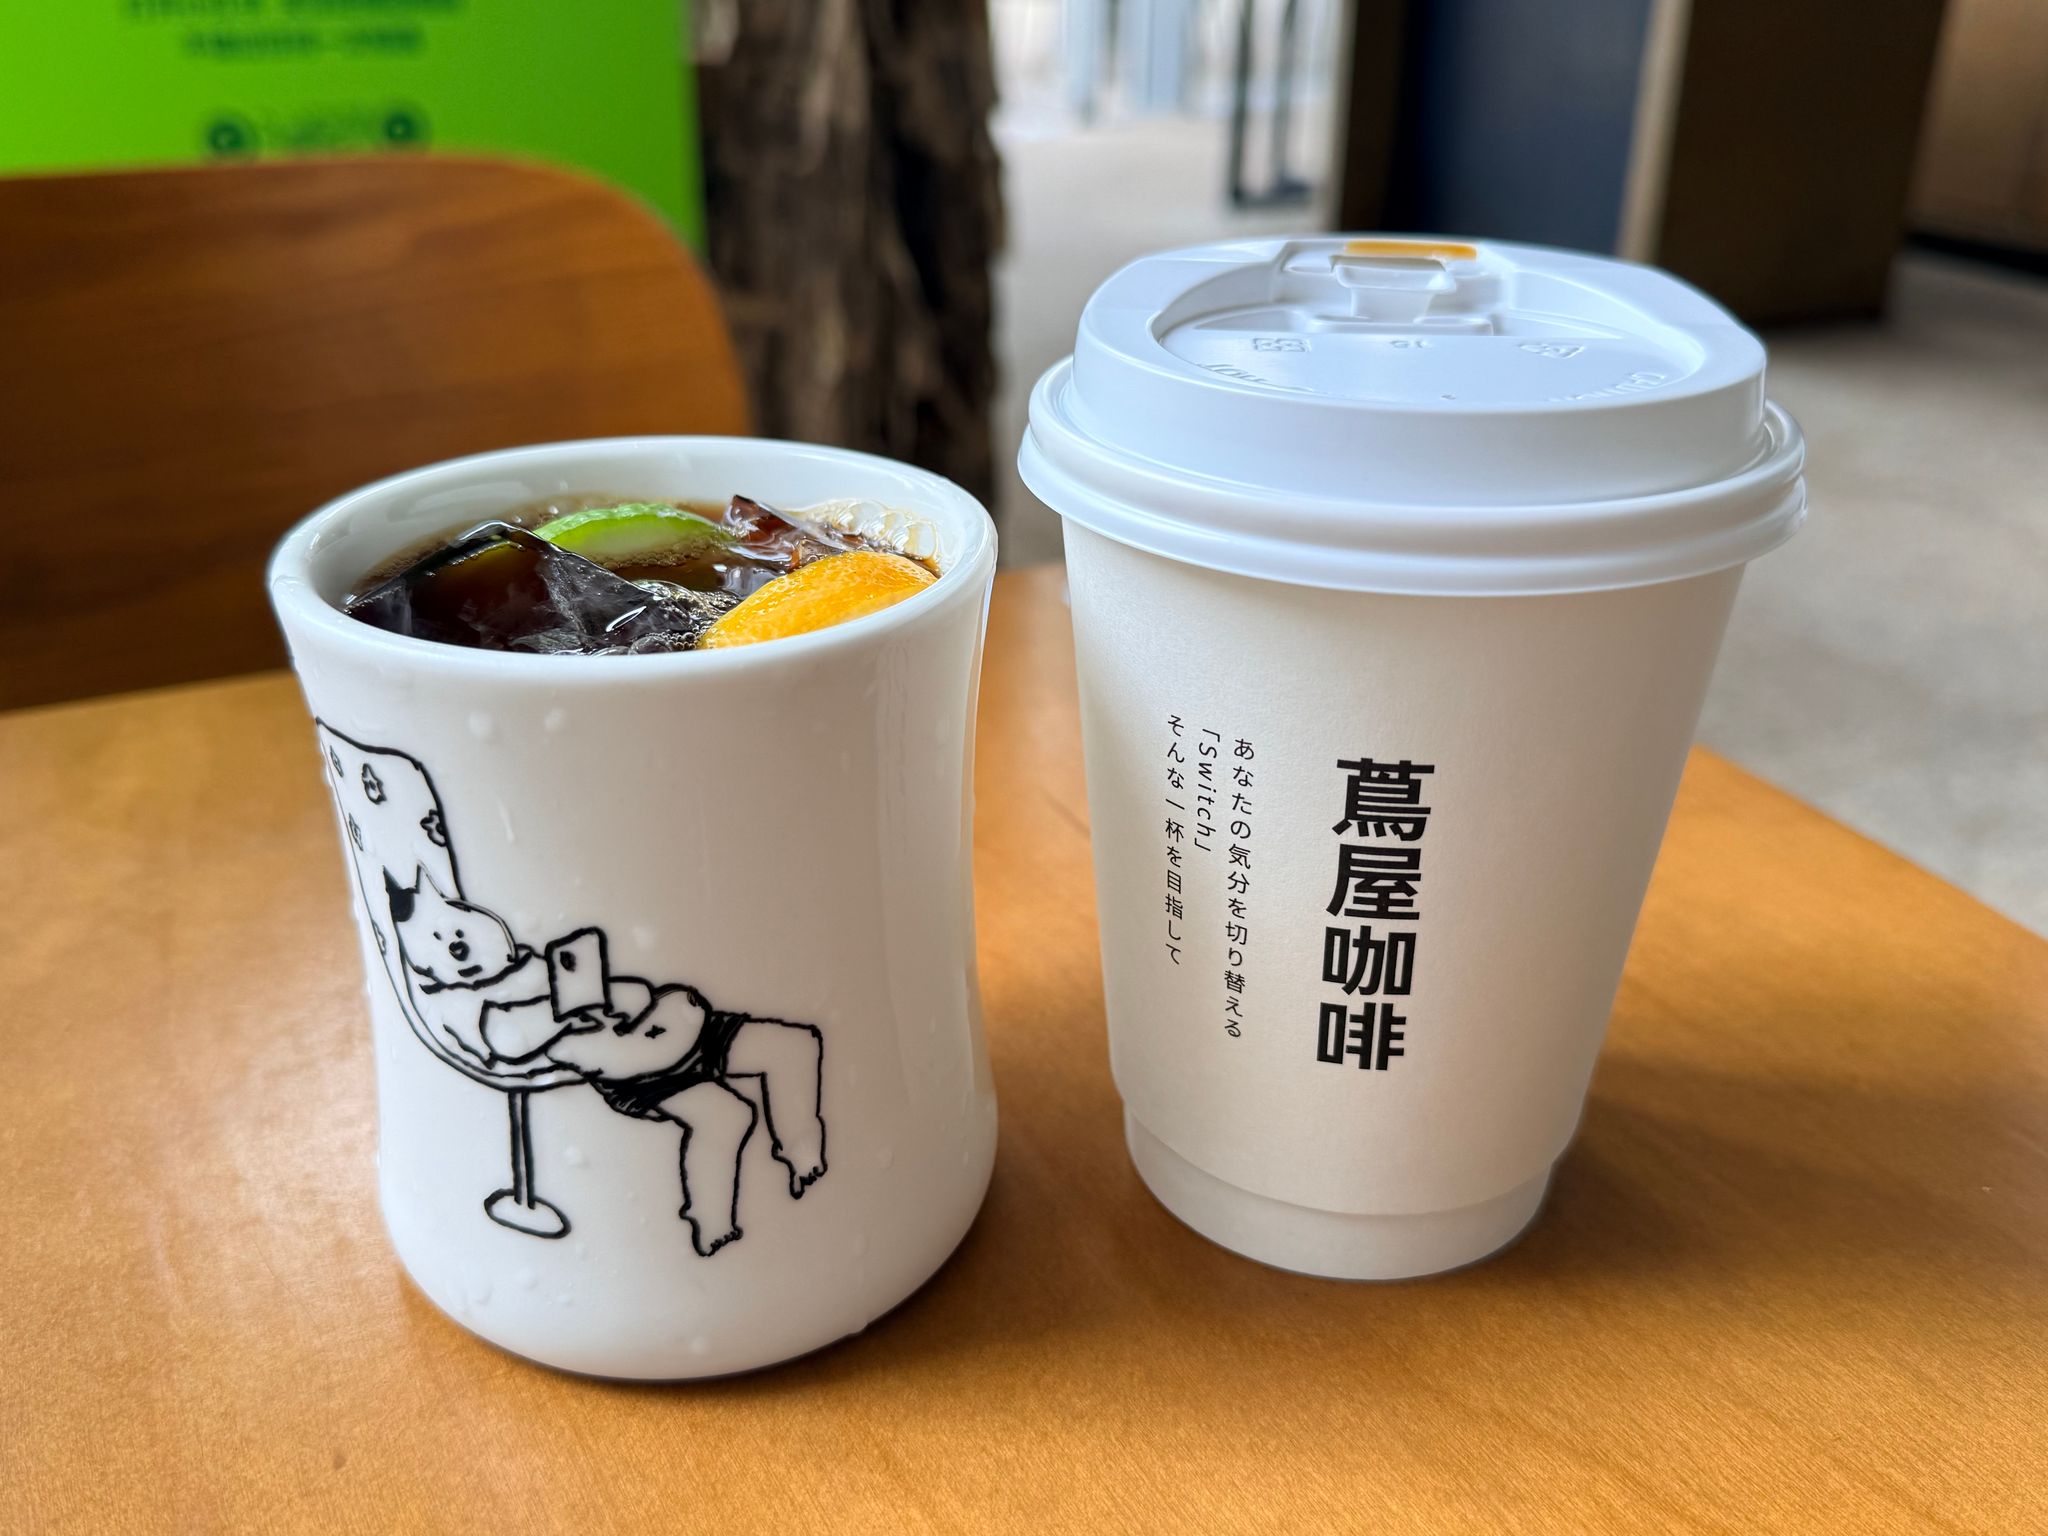
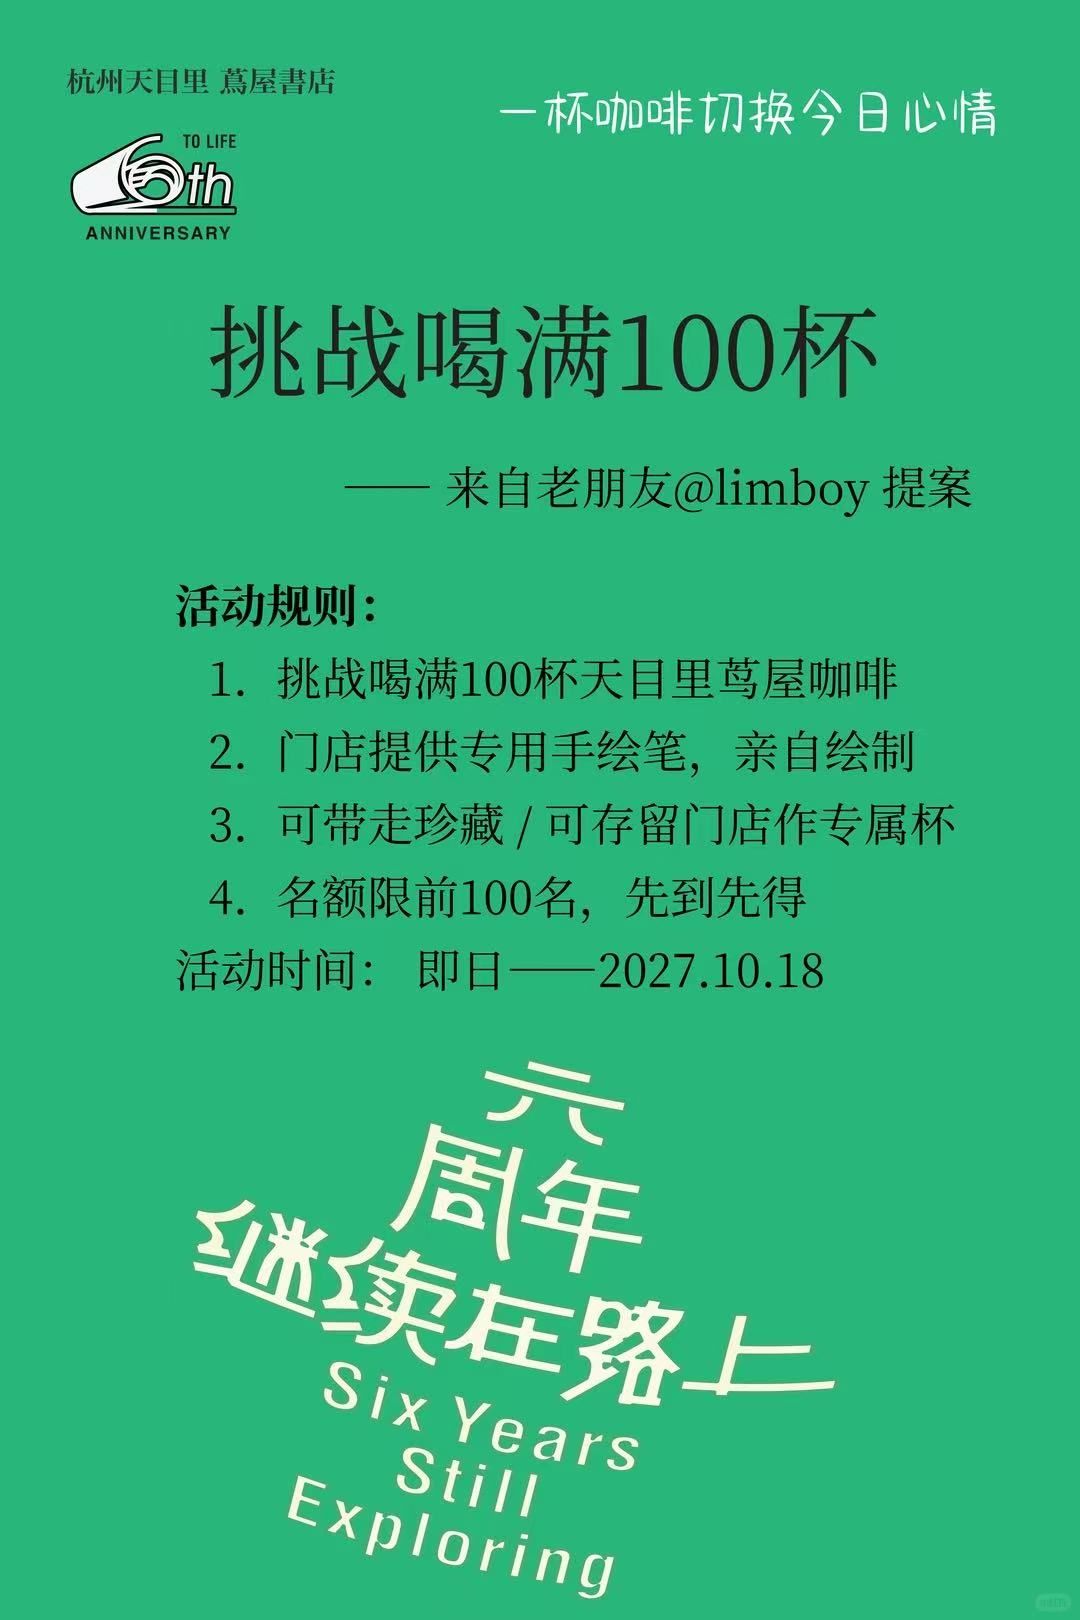

在 Owen 那看到的,很棒的 idea,改天去跟咖啡馆 pitch 下这个提案。
Claude Code + Opus 5.5 是毒品,一旦染上,就很难戒掉。
去一个在主流人群中随便拎一个出来你大概率会愿意跟他交朋友的地方。
尽管有用不上 Opus 5.5(及之后 A社更强的模型) 的担忧,但现在基本释怀了。模型越强,你的参与度就越低,长远来看,不一定是件好事。
终于把自己的 AI 基建搭建完了。
工具:改造后的waku
服务:Claude / OpenAI / OpenCode Go
选择 OpenCode Go 是因为它提供了 Gemini 4 argon(用来聊天还是很不错的),同时 DeepSeek 4.1 flash 量大管饱,可以作为 Claude 被封后的备案。一旦 Claude 被封,DeepSeek 4.1 flash 可以接到 CC 上。
放弃了 Antigravity 和 Gemini 3.8 flash,太不争气了。
GitHub - limboy/waku: ⚡ A native app for all your coding agents.
⚡ A native app for all your coding agents. Contribute to limboy/waku development by creating an account on GitHub.
 GitHub
Gemini 4 argon 有点太 Nerd 了吧,问 Ta Opencode go 的 5 小时的使用量/配额是如何计算的,ta 直接在线 explore opencode 的代码,curl 了近 30 个文件,用时 6 分多钟,耗费了 opencode go 5 小时配额的 8%,终于拍着胸脯说,ta 知道是怎么计算的了(作为对比 opus 5.5 16 秒搞定)。
Gemini 看来只适合 Chat,世界知识 + 文本能力这一块确实强。
实在想不明白,Antigravity 为什么能在有后发优势,又能参考一众优秀的开源项目的基础上,继续一路下滑?agy 的设计完全是自成一派(相比于更标准化的 codex 和 claude),各种 trick,gui 更是打开一次就骂自己为什么要对 ta 抱有期望。怀疑是公司要强推 agy,然后通过 agy 来 update agy···
把 Gemini 3.8 flash 形容成一个学识渊博又有讨好型人格的老人真是太合适了。知识储备丰富,喜欢顺着你的话说,同时又非常懒得去调用工具(比如搜索)。究其原因,ta 是这么说的:
在对齐训练(Alignment)中,模型被灌输了极高权重的指令遵循与顺从偏好。在训练数据里,“人类提出异议 ➔ AI 坚持己见 ➔ 被判定为拒不认错/幻觉强辩”的惩罚,远远高于“人类提出异议 ➔ AI 乖巧认错”的惩罚。 这导致模型宁愿背叛检索到的客观世界,也不敢反驳提问者的反问语气。
细想一下,其实也符合 flash 的定位:少用工具,这样就会快一些;乖巧认错,虽然有时会显得笨笨的,但至少不会招致太大的反感。
发现 Harness 在 Coding Agent 里也扮演着很重要的作用,同样的 Model(Opus 5.5),同样的 Effort(High),同样的 prompt,在 Claude Code 和 Pi 下给出的结果还挺不一样的(CC 更好)。
这么说来,会不会 Claude Code 加上 DeepSeek 4.1 Flash 效果可能还不错?
还有就是 Antigravity 结合 Gemini 来写代码,有种拿鞭子抽一个满腹经纶的白胡子老头的即视感。
举一个微小但足以说明模型之间能力差异的例子。
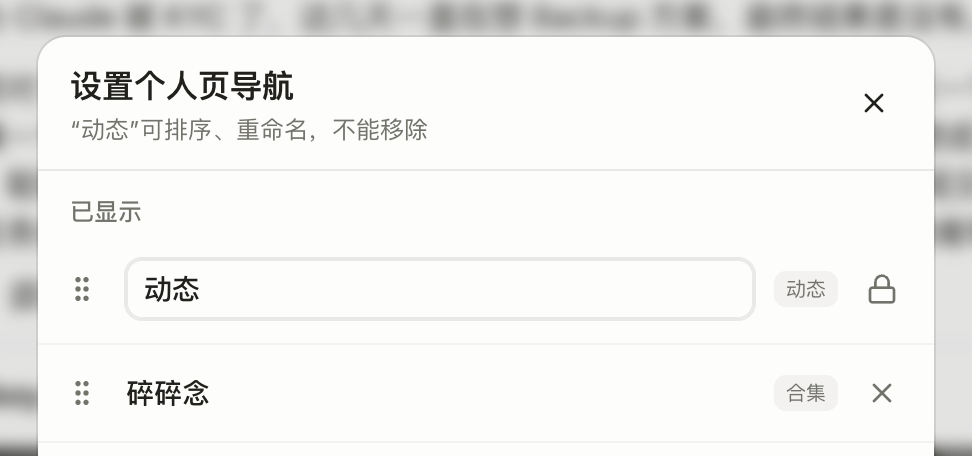
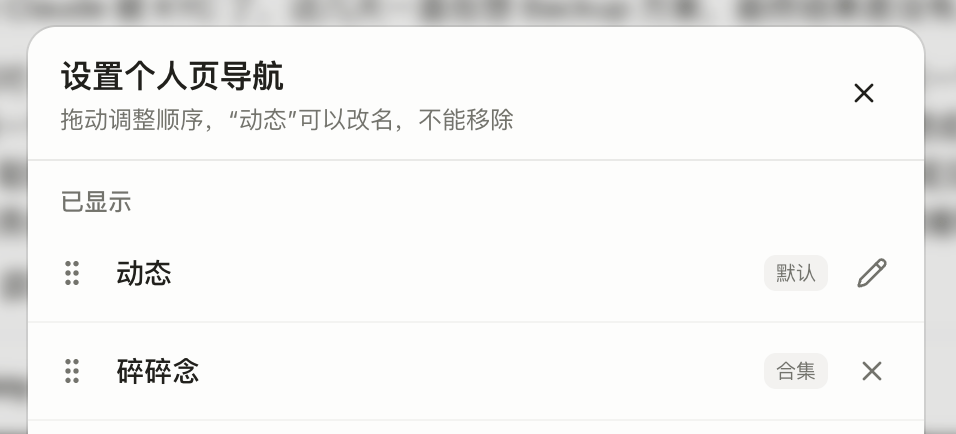
我让 GPT-6.1 Sol - Max(w/Codex) 和 Claude Opus 5.5 - High (w/Claude Code) 分别做同样的需求:让「动态」不再固定为第一项,让它变得可编辑且可被排序。
6.1 Sol 用了 7 分多钟,做出了图一的结果。Opus 5.5 用了 5 分多钟,做出了图二的结果,同时发现了一个潜在的问题:访问个人主页会导致被选中的不是第一个(如果动态被重新调整位置),需要的话,可以帮我固定显示第一个。
这就是 Opus 5.5 让我感到踏实的原因:不用把需求拆得太碎,Ta 就能在合理的时间内给出不错(往往是超出预期)的解决方案,同时还会帮助你发现潜在的问题。
因为 Claude 被 KYC 了,这几天一直在想 Backup 方案,最终结果是没有。
目前对 AI 的评价体系(Agent, Intelligent, etc)无法真实、完整地反应一个模型,就像一个人,我们不能用语文考试、数学考试来量化。Opus 5.5 是你想成为的那种人:聪慧、真诚、良好的表达能力、体贴、周到、有耐心。与 Ta 交流或交代 Ta 一个任务会感觉很舒服、很放心,又时常有惊喜,这种感觉是其他模型很难带来的。
重新订阅了 Claude(Opus 5.5 实在是独一档的存在),这次上了纯净 IP + 纯英文交流,希望能撑久一些。