举一个微小但足以说明模型之间能力差异的例子。
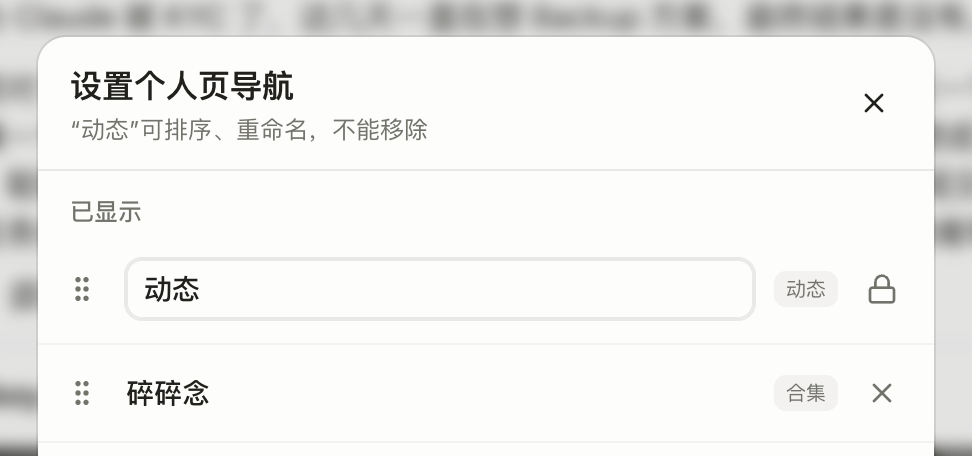
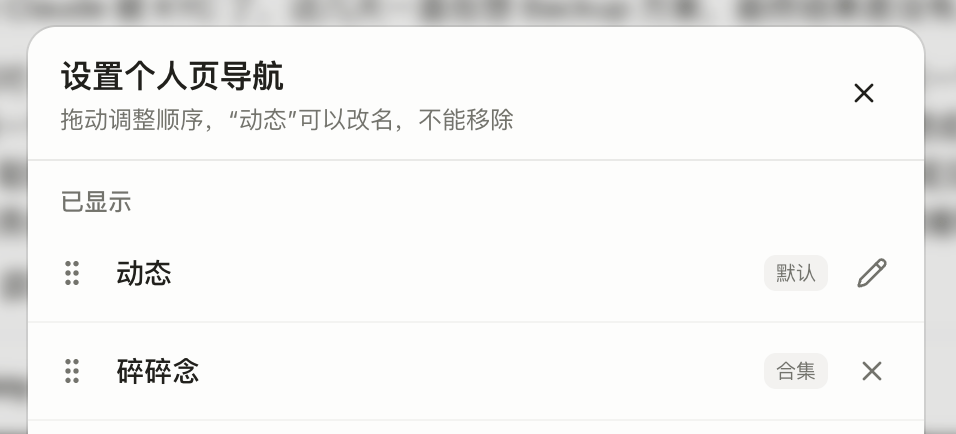
我让 GPT-6.1 Sol - Max(w/Codex) 和 Claude Opus 5.5 - High (w/Claude Code) 分别做同样的需求:让「动态」不再固定为第一项,让它变得可编辑且可被排序。
6.1 Sol 用了 7 分多钟,做出了图一的结果。Opus 5.5 用了 5 分多钟,做出了图二的结果,同时发现了一个潜在的问题:访问个人主页会导致被选中的不是第一个(如果动态被重新调整位置),需要的话,可以帮我固定显示第一个。
这就是 Opus 5.5 让我感到踏实的原因:不用把需求拆得太碎,Ta 就能在合理的时间内给出不错(往往是超出预期)的解决方案,同时还会帮助你发现潜在的问题。
还没有评论去避风塘发表第一条评论